

Ma már elegendő egy egyszerű kérést megfogalmaznunk a legtöbb közismert MI-alkalmazásnak és rövid időn belül elkészül a kívánt kép. Vagy mégsem pontosan az? De nézzük csak, hogyan is történik ez jelenleg a gyakorlatban.
Általánosságban, ha létrehozunk egy mesterséges intelligencia által generált új alkotást (képet, zenét, videót) legalább két eszközt használunk, működtetünk. A nagy nyelvi modellek (pl. Gemini, Copilot, ChatGPT) egyikét és a konkrét generáló eszközt, ami a képek esetén leggyakrabban egy diffúziós modell (pl. DALL·E, Midjourney, Stable Diffusion). A folyamatban nagy nyelvi modellekre egyfajta közvetítőként két fontosabb szerep hárul. Értelmezi a felhasználó kérését és szükség esetén tovább fejleszti a parancssort, azaz lefordítja, pontosítja a generáló eszköz számára.
Ez annál is inkább fontos, mert a képgeneráló eszközök jelentős részét angol nyelven tréningezték (tanították), így a nyelvi pontatlanságokat is jobban kiszűri egy erre a célra optimalizált modell.
Az így kapott utasítás (prompt) alapján a diffúz képgeneráló modellek pedig pixelről-pixelre haladva építik fel a képet. Pontosabban egy hatalmas véletlenszerűen összerakott pixelhalmazból kiszűrik a zajt és a folyamat végén marad a letisztult kép.
Nézzünk erre egy példát! Az egyik kedvenc szerkesztőtársamat a Geminit egy meglehetősen elnagyolt és félreérthető parancssorral arra kértem, hogy „készíts egy képet, amelyen egy nagy fekete macska halad át a zebrán a jelzőlámpa piros jelzésénél és az autósok türelmesen várják, ahogy áthalad.”
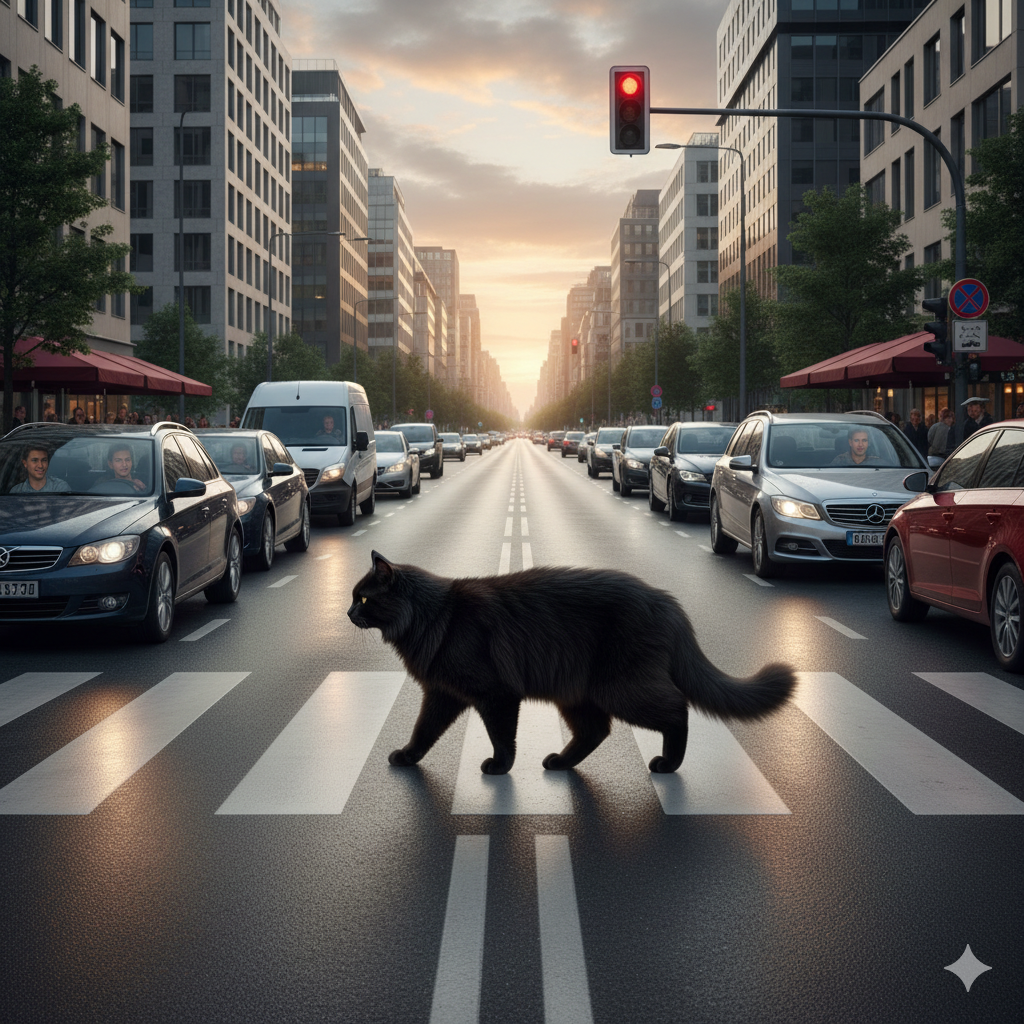
A Gemini ezt az alábbiak szerint fordította le a Google által fejlesztett képgeneráló alkalmazásnak:
„A large black cat is crossing a crosswalk on a busy city street. The traffic light is red, and cars are patiently waiting for the cat to cross. The scene is set in a modern city with tall buildings and a few pedestrians on the sidewalk. The lighting is natural, as if it’s either early morning or late afternoon.”
Tudatosan fogalmaztam pontatlanul a gyalogátkelőhely esetén a zebrát használva, de ezt még simán megoldotta és nem egy zebrán lovagló macskát kaptunk. Az viszont, hogy a „fekete macska a jelzőlámpa piros jelzésénél halad át”, minimum kétértelmű. Az MI egyértelműsítette. Abban a formában, ahogy logikusnak gondolta. Nem a macska, hanem az autók kaptak piros jelzést. Ráadásul kiegészítette néhány képi elemmel, hangulati instrukcióval a kérést. Egyszóval elvégezte a dolgát.
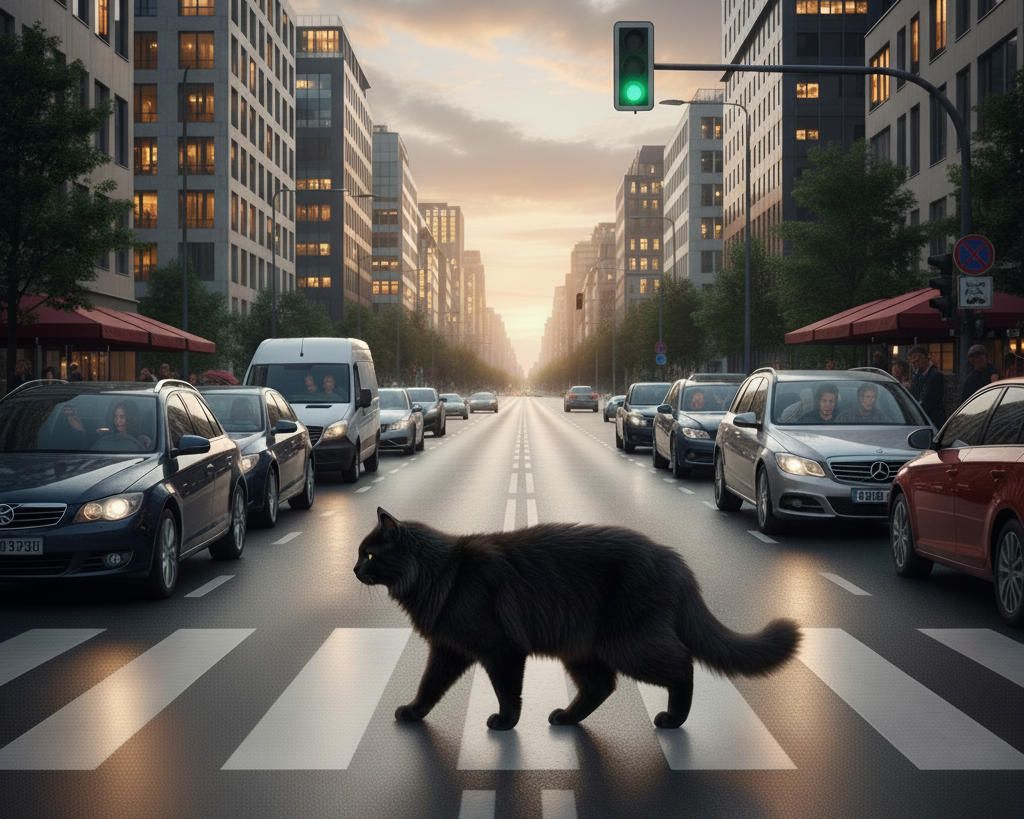
Az így továbbított prompt alapján a képgeneráló viszonylag gyorsan dolgozott. Innen kezdve jöhet a finomítás, a további interakciók. Ennek eredménye lett a következő kép. Az épületekre kértem elszórtan világító fényeket, valamint egy kicsit kevesebb autót az úttestre, és szabad jelzést az autóknak. Ezeket sikerült jól megoldania. Emellett szerettem volna, hogy mind a négy sávban álljanak autó, de itt kölcsönös értelmezési problémáink akadtak, melynek a végén, mikor önvizsgálatra kértem, közölte, hogy az utasításaim precízek voltak, és a hiba az Ő oldalán áll fenn, amit továbbít is a fejlesztői csapatának.
Ha a működési módról beszélünk fontos megjegyezni, hogy a jelenleg leginkább elterjedt diffúz képalkotó modellekre is lehet úgy tekinteni, mint komplex AI alkalmazásokra, hisz közvetlenül elérhetőek, a nyelvi modellek nélkül is képesek képeket készíteni, parancsokat értelmezni. Az LLM-ek lényegében integrálták a szolgáltatásaikat. A diffúz modellek működését pedig úgy lehet a legjobban megérteni, ahogy a Gemini is összefoglalta nekem:
„Képzeld el, hogy van egy tiszta, felismerhető képed, és fokozatosan adsz hozzá zajt, amíg az teljesen felismerhetetlenné nem válik. A diffúziós modell pontosan ennek a folyamatnak a fordítottját tanulja meg.
- Tanulási fázis: A modellt hatalmas adathalmazokon képzik, amelyek képeket és azokhoz tartozó szöveges leírásokat tartalmaznak. A modell azt tanulja meg, hogyan kell a zajt lépésről lépésre eltávolítani egy zajos képből, hogy az újra felismerhetővé váljon. A képzés során a modell megérti, hogy melyik zajréteget kell eltávolítani ahhoz, hogy a kép a leírással egyezővé váljon.
- Generálási fázis: Amikor te adsz egy szöveges parancsot (promptot), a modell véletlenszerű zajjal (pixelek kaotikus halmaza) kezd. Ezt a zajt a promptod alapján fokozatosan „kitisztítja”, lépésről lépésre távolítva el belőle a zajt. Minden egyes lépésnél egyre közelebb kerül a kívánt képhez, amíg egy tiszta és részletes végeredményt nem kap.”
Borítókép: Copilot